مدل زبانی بزرگ (LLM) چیست و چطور کار میکند؟
مدل زبانی بزرگ یا LLM به زبان ساده: چطور آموزش میبیند، نمونههای معروف، محدودیتها و راه استفاده درست در کسبوکار.
پشت ChatGPT، Gemini، Claude و تقریباً همه چتباتهای هوشمند امروزی یک فناوری مشترک است: «مدل زبانی بزرگ» یا LLM. اگر میخواهید بدانید این ابزارها چطور متن میفهمند و مینویسند، باید اول بدانید LLM چیست.
در این مقاله به زبان ساده توضیح میدهیم مدل زبانی بزرگ چیست، چطور آموزش میبیند، چه چیزی آن را «بزرگ» میکند و برای استفاده درست از آن در کسبوکار چه چیزهایی را باید بدانید.
مدل زبانی بزرگ (LLM) چیست؟
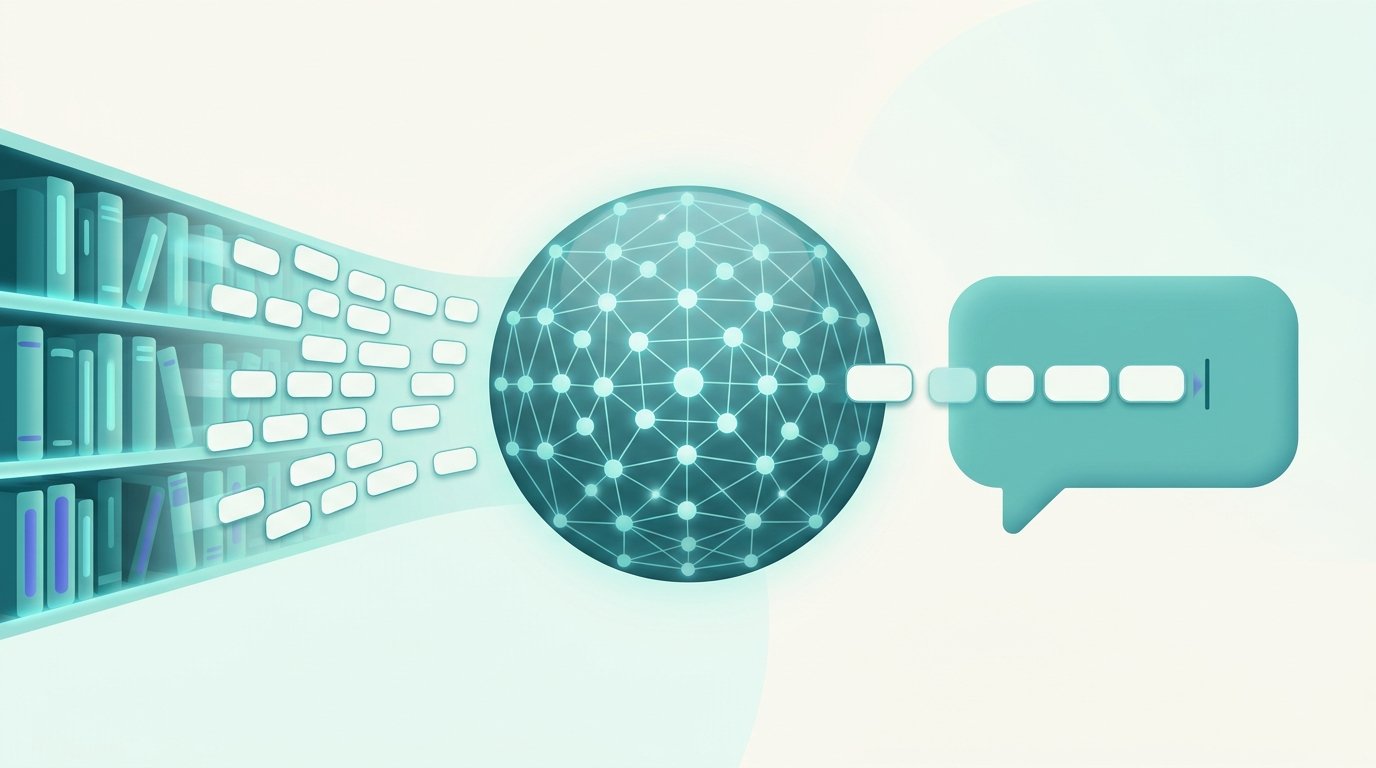
مدل زبانی بزرگ (Large Language Model) نوعی مدل هوش مصنوعی است که روی حجم بسیار زیادی متن آموزش دیده تا زبان انسان را بفهمد و تولید کند. IBM در معرفی مدلهای زبانی بزرگ آنها را مدلهایی توصیف میکند که با دیدن مقدار عظیمی داده، توانایی فهم و تولید زبان طبیعی را پیدا میکنند.
کار اصلی یک LLM ساده به نظر میرسد: پیشبینی کلمه بعدی. وقتی مینویسید «پایتخت ایران»، مدل پیشبینی میکند محتملترین ادامه «تهران است» است. اما وقتی این پیشبینی روی میلیاردها جمله تمرین شده باشد، نتیجه میشود مدلی که میتواند ایمیل بنویسد، متن خلاصه کند، ترجمه کند و به سؤال جواب دهد.
چرا «بزرگ»؟
بزرگ بودن به دو چیز اشاره دارد:
- حجم داده آموزشی: متنهای بسیار زیادی از کتاب، وبسایت، مقاله و کد.
- تعداد پارامترها: پارامترها اعدادیاند که مدل در طول آموزش تنظیم میکند؛ چیزی شبیه «حافظه» الگوهایی که یاد گرفته. مدلهای امروزی میلیاردها پارامتر دارند.
LLM چطور آموزش میبیند؟
آموزش یک مدل زبانی معمولاً دو مرحله اصلی دارد:
- پیشآموزش (Pre-training): مدل روی حجم عظیمی متن تمرین میکند تا کلمه بعدی را پیشبینی کند. در این مرحله دستور زبان، اطلاعات عمومی و الگوهای استدلال را یاد میگیرد.
- تنظیم دقیق (Fine-tuning): مدل با مثالهای گفتگو و بازخورد انسانی یاد میگیرد مثل یک دستیار مفید رفتار کند، دستورها را دنبال کند و از جوابهای مضر پرهیز کند.
پایه فنی تقریباً همه این مدلها معماری ترنسفورمر است که در مقاله Attention Is All You Need در سال ۲۰۱۷ معرفی شد. ویژگی کلیدی آن «توجه» است: مدل میتواند بفهمد هر کلمه در جمله با کدام کلمههای دیگر ارتباط دارد.
نمونههای معروف مدلهای زبانی
- GPT از OpenAI، پایه ChatGPT
- Gemini از گوگل
- Claude از Anthropic
- DeepSeek از یک شرکت چینی، با نسخههایی که وزنهایشان منتشر شده
- Llama از متا
مقایسه اینها را در مقاله ChatGPT، Gemini، Claude یا DeepSeek؟ آوردهایم.
محدودیتهای LLM
- دانشش تاریخ دارد. مدل فقط چیزی را میداند که تا زمان آموزش دیده است. اطلاعات تازه یا اختصاصی شما را نمیداند.
- ممکن است جواب بسازد. چون کارش پیشبینی متن محتمل است، گاهی جوابی روان ولی نادرست میدهد. این را توهم هوش مصنوعی مینامند.
- منبع جوابش مشخص نیست. یک LLM خام نمیگوید جوابش را از کجا آورده است.
راهحل کسبوکارها: اتصال LLM به اسناد خودتان
برای اینکه یک مدل زبانی درباره کسبوکار شما درست جواب دهد، لازم نیست آن را از نو آموزش دهید. روش رایج و بهصرفه، RAG است: سیستم اول در اسناد شما جستجو میکند، بخشهای مرتبط را پیدا میکند و به مدل میدهد تا بر اساس همانها جواب بنویسد. این روش در مقاله اصلی RAG در سال ۲۰۲۰ معرفی شد و در مقاله RAG چیست؟ آن را ساده توضیح دادهایم.
دستیار هوشمند آیوا دقیقاً همین کار را میکند. شما فایلهای PDF، DOCX یا TXT را بارگذاری میکنید و دستیار از روی همانها به مشتریان جواب میدهد.
جمعبندی
مدل زبانی بزرگ موتور اصلی چتباتهای هوشمند امروزی است: مدلی که با پیشبینی کلمه بعدی، زبان را میفهمد و تولید میکند. قدرتش در روانی و انعطاف است و ضعفش در دانش محدود به زمان آموزش و احتمال ساختن جواب. اتصال آن به اسناد معتبر، مهمترین راه برای استفاده مطمئن از آن در کسبوکار است.
با آیوا دستیار هوشمندی بسازید که از اسناد شما جواب میدهد؛ دوره آزمایشی رایگان است.
- مدل زبانی بزرگ
- مفاهیم هوش مصنوعی